
为什么你的 AI 视频总像“随机抽卡”?
用 Sora、Runway Gen-3、可灵或 Luma 生成视频时,很多人写提示词的习惯还停留在“一只猫在草地上跑”这种描述层面。结果就是:镜头忽远忽近、主体莫名变形、画面节奏完全失控。问题的根源不在于模型能力不足,而在于提示词没有对镜头语言进行结构化约束。
文生视频模型本质上是“空间+时间”的联合建模系统。它不仅要理解画面里有什么,还要推断这些元素在时间轴上如何运动、摄像机如何介入。如果你只给语义内容,模型就会用训练数据里最常见的运镜方式去“猜”——这就是“随机抽卡”感的来源。真正可控的生成,需要你把提示词写成一份可执行的拍摄脚本,而不是一句文学描述。
镜头语言提示词的四个控制层
要让 Sora 或主流模型稳定输出你想要的效果,提示词需要覆盖以下四个层级。缺一层,控制力就会断崖式下降。
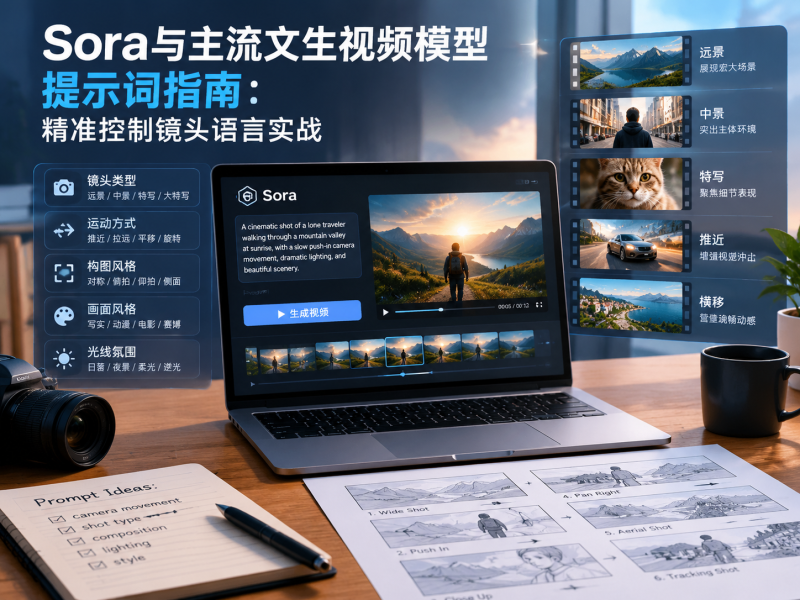
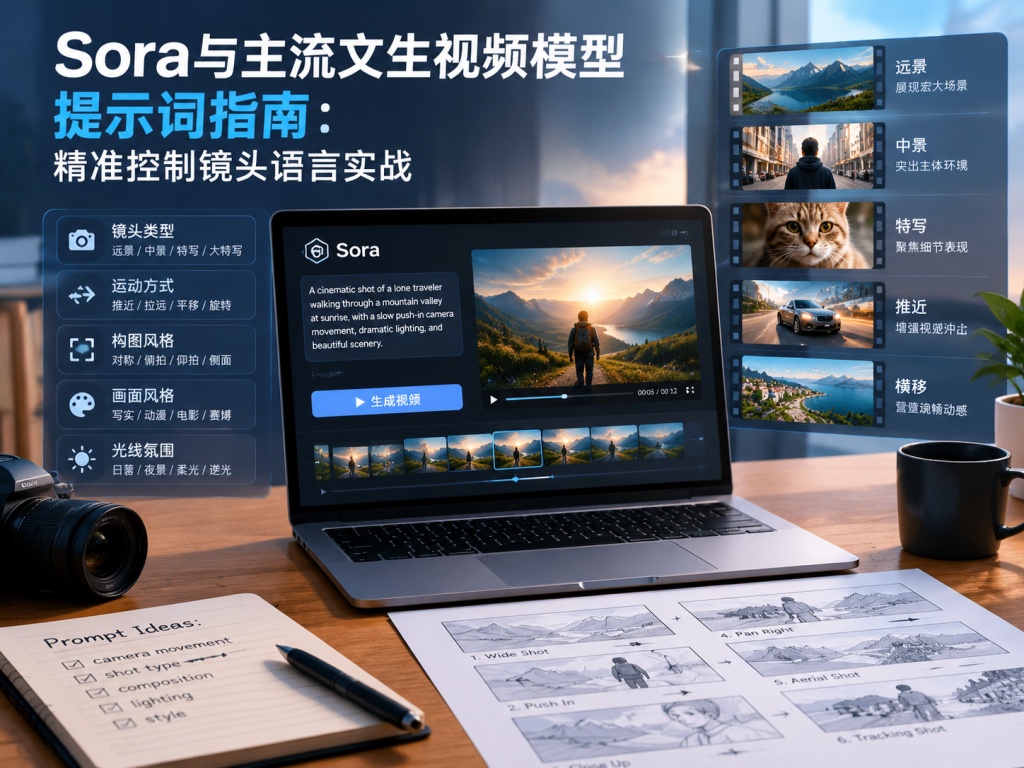
- 景别(Shot Size):决定观众与主体的距离感。常用选项包括 extreme wide shot(大远景)、wide shot(全景)、medium shot(中景)、close-up(特写)、extreme close-up(大特写)。景别是镜头语言的“地基”,写错景别,后面所有参数都会跑偏。
- 运镜方式(Camera Movement):静态镜头用 static shot 或 locked-off shot;动态镜头包括 pan(横摇)、tilt(纵摇)、dolly in/out(推拉)、tracking shot(跟拍)、crane shot(升降)、handheld(手持晃动感)。多个运镜叠加时,必须用 and 明确连接顺序,否则模型会随机选择。
- 镜头焦段与视角(Lens & Angle):广角镜头(wide-angle lens)适合强调空间纵深,长焦(telephoto lens)压缩背景、突出主体;低角度(low angle)增强压迫感,高角度(high angle)制造俯视的渺小感。这些词汇在 Sora 和 Runway Gen-3 中都有较好的语义响应。
- 时间节奏(Temporal Pacing):slow motion(慢动作)、real-time(实时速度)、time-lapse(延时)。节奏词直接影响帧间插值的密度,写与不写,成片速度感差异明显。
主流模型对镜头语言的响应差异
不同模型对镜头术语的理解能力并不一致,提示词策略需要“看模型下菜”。根据实测反馈与公开技术文档,可以整理出以下参考:
- Sora:对复杂运镜组合和物理连贯性的理解较强,支持较长的提示词。建议用完整句子描述镜头运动路径,例如“The camera slowly dollies in from a wide shot to a medium close-up, keeping the subject centered.”
- Runway Gen-3:对简洁、结构化的镜头指令响应更稳定。推荐用“Shot type + Subject + Action + Camera movement”的短句模板,避免过多修辞。
- 可灵(Kling):中文提示词友好,运镜词建议用中文明确表达,如“镜头从远景缓慢推至中景,主体始终位于画面中央”。对“推拉摇移”等术语有专门优化。
- Luma Dream Machine:对自然语言描述运镜的接受度较高,但对极端景别切换的稳定性一般,建议单镜头内只做一次运镜变化。
需要提醒的是,各平台的模型版本和接口能力会持续更新,具体支持程度请以官方最新文档为准。在实际操作中,建议先用短提示词测试模型对某个镜头术语的响应,再逐步叠加控制层。
一个可复用的镜头语言提示词骨架
把上述四层控制整合起来,可以得到一个通用骨架:
[景别] + [主体与动作] + [运镜方式] + [焦段/视角] + [节奏] + [氛围与光影]
例如:“Medium shot of a cyclist riding through a narrow alley, camera tracks alongside from left to right, 35mm lens, low angle, real-time pacing, warm afternoon light with soft shadows.”
这个骨架的价值在于:它把“画面内容”和“镜头行为”分开描述,模型更容易分别解析。下一部分,我们会针对 Sora、Runway、可灵分别给出可直接复制的中英文提示词模板,并拆解多镜头序列的写法。
镜头提示词实战模板:从 Sora 到可灵、Runway 的通用写法
理论拆解之后,真正决定成片质量的,是你能否把镜头意图压缩成模型可解析的提示词结构。无论使用 Sora、可灵、Runway Gen-3 还是 Luma Dream Machine,当前主流文生视频模型对镜头语言的理解都遵循一个共性逻辑:主体 + 动作 + 镜头类型 + 运动方式 + 环境光影 + 风格约束。把这六个维度写成一句连贯英文,比堆砌十个形容词更有效。
以下是一套可直接复用的镜头控制模板,按景别与运动拆分,替换方括号内容即可:
- 推镜特写:Close-up shot of [主体] [动作], slow push-in, shallow depth of field, soft rim light, cinematic tone
- 拉镜全景:Wide shot pulling back from [主体] to reveal [环境], smooth dolly out, golden hour, 35mm film look
- 环绕跟拍:Orbiting camera around [主体] while [动作], steady tracking, blurred background, natural lighting
- 低角度仰拍:Low-angle shot looking up at [主体], slow tilt up, dramatic shadow, high contrast
- 手持纪实:Handheld shot following [主体], slight shake, documentary style, ambient light
需要特别注意,Sora 对物理连续性与镜头运动的理解明显强于早期模型,但仍需避免在同一提示词中叠加互斥指令,例如同时写 “static camera” 与 “fast pan”。可灵与 Runway 则对中文语义更友好,可直接使用“缓慢推近”“环绕运镜”等表述,但建议关键镜头词保留英文,降低歧义。
实操中还有三个高频避坑点:
- 一个镜头只写一种运动。多运动叠加会导致画面抖动或主体变形,需要多镜头时拆成多次生成再剪辑。
- 用时间词替代模糊副词。把 “quickly” 换成 “within 2 seconds”,模型对节奏的响应更稳定。
- 光影与镜头绑定描述。例如 “backlit silhouette in push-in” 比单独写 “backlight” 更能锁定氛围。
镜头语言的精准控制,本质是把导演思维翻译成模型可执行的参数语言。掌握上述模板后,建议建立自己的提示词资产库,按景别、运动、风格分类沉淀,逐步形成可复用的镜头配方。需要提醒的是,各平台的模型版本与功能持续迭代,具体参数与支持能力请以官方最新公布为准。把每一次生成当作一次镜头测试,你的提示词控制力会以肉眼可见的速度提升。
如果你希望进一步了解和体验不同的 AI 模型与前沿工具,可以访问 淡泊Ai (danbo.ai) 平台聚合前沿大模型实战、提示词库、自动化工作流与精选资源,适合用于 AI 写作、学习、办公、编程以及图片与视频创作。你可以根据自己的实际需求,探索更高效的 AI 工具与落地实操方式。
免责声明:本站提供用户下载的所有资源均来自网络,版权归作者本人所有,仅限学习和研究目的的,请支持正版!
我们非常重视版权问题,如有侵权请邮件与我们联系处理。敬请谅解!邮件:888i@88.com


暂无评论内容