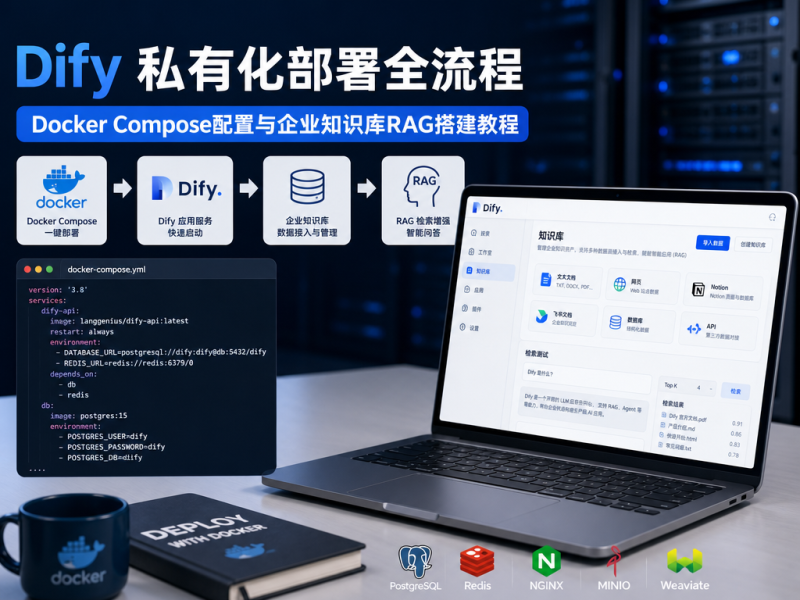

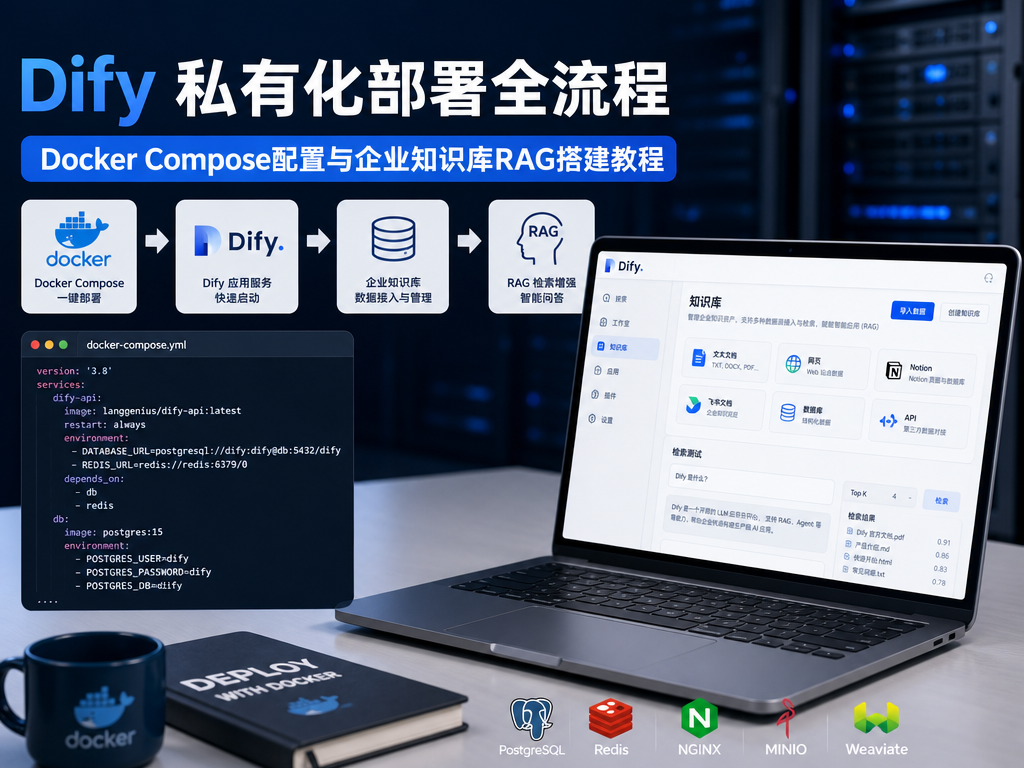
很多团队在评估 Dify 时,第一步就卡在部署方式上——SaaS 版虽然开箱即用,但企业内部的合同、技术文档、客户数据一旦上传到第三方平台,合规与安全审查就很难通过。于是私有化部署成了刚需:数据留在自己的服务器上,模型可以接本地推理服务,知识库的切片、向量化、召回策略全部自主可控。好消息是,Dify 官方提供了完整的 Docker Compose 编排方案,只要你的机器满足基本配置,半小时内跑起来一套可用的环境并不困难。
这篇教程面向有一定 Linux 基础的运维或后端同学,从环境准备、Docker Compose 配置、模型接入到企业知识库 RAG 的完整搭建,逐步拆解。如果你只是想快速体验,可以先跳过集群与反向代理部分;如果准备上生产,建议把本文的配置项逐条对照检查。
一、部署前的环境准备与硬件评估
Dify 的组件不算多,但涉及向量数据库、缓存、异步任务队列和 Web 服务,资源占用需要提前规划。以下是一份经过验证的最低与推荐配置参考,实际表现会因模型推理是否同机部署而差异很大。
- 最低配置:2 核 CPU / 4GB 内存 / 20GB 磁盘,仅适合单用户体验与功能验证,向量检索量大时容易 OOM。
- 推荐配置:4 核 CPU / 8GB 内存起步,若在宿主机上同时跑本地大模型(如 Ollama 承载 7B 量化模型),建议 16GB 内存以上并配备 GPU。
- 操作系统:Ubuntu 22.04 LTS 或 Debian 12 是社区验证最充分的组合,CentOS Stream 亦可,但需注意 Docker 版本兼容性。
- 必要依赖:Docker Engine 20.10+ 与 Docker Compose v2。注意
docker-compose(v1)与docker compose(v2 插件)命令差异,Dify 官方脚本已适配 v2。
安装 Docker 时,建议直接使用官方脚本,避免发行版仓库里的旧版本:
curl -fsSL https://get.docker.com | sh
sudo systemctl enable --now docker
docker compose version
另外,提前放行防火墙端口或确认云服务器安全组策略。Dify 默认会暴露若干端口,生产环境务必通过 Nginx 反向代理并启用 HTTPS,不要直接把内部服务端口暴露到公网。
二、获取 Dify 源码与 Docker Compose 配置解读
Dify 的部署文件集中在 docker 目录下,核心是 docker-compose.yaml 与 .env.example。推荐用 Git 拉取指定版本标签,而不是直接克隆 main 分支,便于后续升级与回滚。
git clone https://github.com/langgenius/dify.git
cd dify/docker
cp .env.example .env
在启动之前,先理解 Compose 文件里的几个关键服务,这决定了你排查问题时的方向:
- api:后端核心服务,负责应用编排、知识库管理与模型调用,是日志排查的第一入口。
- worker:Celery 异步任务进程,文档解析、向量化、索引构建都在这里执行,卡住时优先看它的日志。
- web:前端控制台,通过 Nginx 对外提供访问。
- db:PostgreSQL,存储应用配置、会话与元数据。
- redis:缓存与消息队列。
- vectordb:默认使用 Weaviate,也可替换为 Qdrant、Milvus 等,RAG 检索性能与它直接相关。
- sandbox:代码执行沙箱,涉及代码节点的应用需要它。
打开 .env 文件,有几项必须修改,否则会影响可用性与安全性:
SECRET_KEY:用于会话加密,务必替换为随机长字符串,可用openssl rand -base64 42生成。INIT_PASSWORD:首次登录的管理员密码,不设置会使用默认值,存在风险。EXPOSE_NGINX_PORT:默认 80,若宿主机已被占用,改成其他端口。VECTOR_STORE:确认与 Compose 中启用的向量库一致,切换后需要重新索引知识库。
配置完成后,用一条命令拉起全部服务:
docker compose up -d
docker compose ps
当所有容器状态显示为 running 或 healthy,浏览器访问 http://你的服务器IP 即可进入初始化页面,设置管理员账号。若页面打不开,先执行 docker compose logs -f api 查看后端是否因数据库连接或迁移失败而退出。
知识库 RAG 检索调优与私有化部署验收清单
完成 Docker Compose 编排与企业知识库上传后,RAG 效果是否达标,取决于分块策略、召回参数与重排模型三者的配合。默认配置能跑通流程,但要让回答真正可用,需要做一轮针对性调优。
分块与召回参数怎么定
Dify 知识库支持自定义分段规则。企业文档常见两类:一是制度、合同、SOP 等结构清晰的文本,建议按段落切分,分段最大长度控制在 500~800 tokens,重叠 50~100 tokens;二是产品手册、FAQ 等碎片化内容,可改用父子分段模式,让子块负责精准命中、父块提供完整上下文。
召回环节重点调三个值:
- Top K:初次检索条数,建议从 4 起步,文档量大可提到 8~10;
- Score 阈值:过滤低相关片段,中文场景一般设 0.5 左右,过低会引入噪声,过高会漏召回;
- Rerank 模型:开启后由重排模型对候选片段二次打分,对多文档混合的知识库提升明显,是私有化环境里性价比最高的一步优化。
Embedding 与 Rerank 的私有化选择
若企业数据不允许出内网,Embedding 与 Rerank 都需本地化。Embedding 可选用 bge-m3、bge-large-zh 等中文表现稳定的开源模型,通过 Xinference 或 Ollama 以 OpenAI 兼容接口暴露,再填入 Dify 的模型供应商配置中。Rerank 可选 bge-reranker 系列,同样以本地服务方式接入。务必保证向量化模型在入库与检索两个阶段完全一致,中途更换模型会导致旧向量失效,需要重新索引。
部署验收与日常维护
上线前建议按以下清单逐项确认:
- 容器状态:
docker compose ps全部为 running,无反复重启; - 数据持久化:确认 volumes 已挂载到宿主机目录,重启容器后知识库与对话记录不丢失;
- 反向代理:Nginx 已配置 HTTPS 与上传体积上限(
client_max_body_size),避免大文件上传失败; - 备份策略:定期备份 PostgreSQL 与向量库数据目录,这是私有化部署最容易被忽略的一环;
- 版本升级:升级前先备份并核对官方 release notes,Dify 迭代较快,跨版本升级存在数据库迁移风险。
需要提醒的是,Dify 的功能、镜像标签与配置项会随版本更新而变化,具体参数请以官方文档与仓库最新说明为准。把这套流程跑通后,你得到的不只是一个问答机器人,而是一套可复用的企业知识资产底座——后续接入工作流、API 或嵌入现有业务系统,都建立在这次私有化部署的基础之上。
如果你希望进一步了解和体验不同的 AI 模型与前沿工具,可以访问 淡泊Ai《https://DanBo.Ai》平台聚合前沿大模型实战、提示词库、自动化工作流与精选资源,适合用于 AI 写作、学习、办公、编程以及图片与视频创作。你可以根据自己的实际需求,探索更高效的 AI 工具与落地实操方式。。
免责声明:本站提供用户下载的所有资源均来自网络,版权归作者本人所有,仅限学习和研究目的的,请支持正版!
我们非常重视版权问题,如有侵权请邮件与我们联系处理。敬请谅解!邮件:888i@88.com


暂无评论内容